Seamos honestos. La última vez que hablamos de implantar Inteligencia Artificial en tu negocio, me soltaste el clásico: «No hay presupuesto, el ROI no está claro y las herramientas son muy caras».
Vale. Acepto el argumento.
Pero luego voy a tu casa, veo el setup de tu hijo y me encuentro con una RTX 4080 Super y un monitor OLED para que el crío pueda jugar a Black Myth: Wukong o al Cyberpunk 2077 en 4K a 60 FPS sin que se le caiga un solo fotograma. Te has dejado 2.500 o 3.000 euros en silicio para que tu hijo cace monstruos o explore Night City.
Y aquí es donde tengo que hacerte una pregunta incómoda: Si tienes dinero para renderizar los poros de la cara de un personaje de videojuego, ¿por qué dices que no tienes dinero para procesar los datos de tu empresa?
Te han vendido la moto de que la IA requiere una infraestructura que solo tiene la NASA. Falso. Te han vendido la moto de que necesitas pagar por cada consulta. Falso.
Mira esta tabla. No es la ficha técnica de un PC gamer, es el mapa de tu próxima ventaja competitiva:
| El «Juguete» de tu hijo (4K / 60 FPS) | La VRAM que paga el pato | Tu «Departamento de IA» Local (Modelos Qwen 3.5 / 3.6 Open Source) | Lo que tu empresa puede hacer (Modalidades) |
|---|---|---|---|
| Monster Hunter Wilds / Horizon | 12 – 16 GB | Qwen3.5-14B / Qwen3.6-8B/9B | Leer, analizar y resumir documentos, planos e imágenes (Visión). |
| Black Myth: Wukong / Cyberpunk / Star Wars | 16 – 24 GB | Qwen3.6-27B / Qwen3.5-35B-A3B (MoE) | Analizar Texto, Imagen, Audio y Video. Ventanas de contexto de hasta 1M de tokens. |
| GTA VI | 24 GB | Qwen3.5/3.6-35B-A3B (MoE) | Análisis multimodal complejo en local. El santo grial de la IA de borde. |
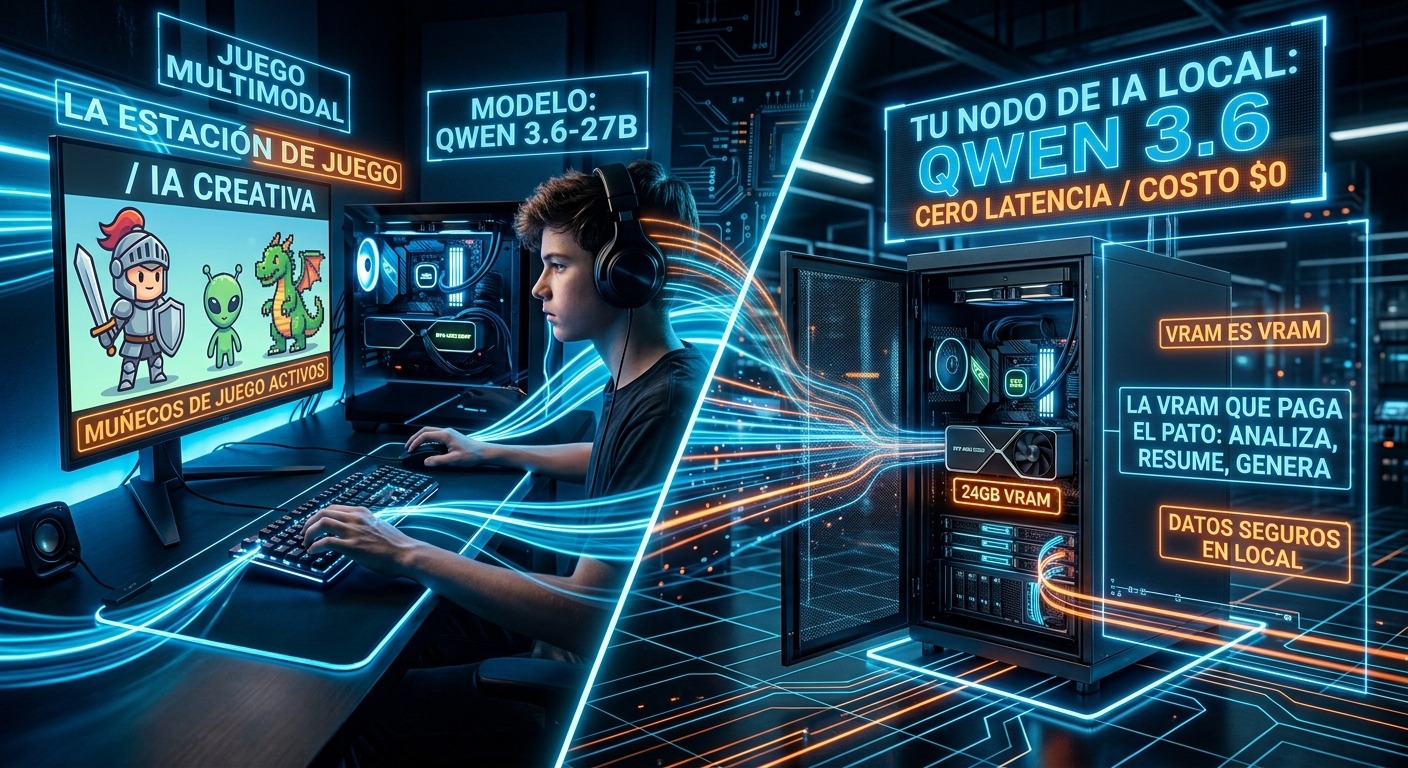
¿Ves el truco? La VRAM es VRAM. A la tarjeta gráfica le da exactamente igual si tiene que calcular los reflejos del ray-tracing en Star Wars Outlaws o si tiene que procesar una ventana de contexto de 1 millón de tokens para revisar los contratos legales de tu departamento jurídico, transcribir las reuniones de ventas o analizar el vídeo de la cámara de seguridad de tu almacén.
El hardware que tu hijo usa para evadirse de la realidad es exactamente el mismo que tu empresa necesita para entenderla.
La gran mentira de las APIs: Sangrar la caja mes a mes
«Pero es que nosotros ya usamos IA, pagamos la API de turno».
Sí, y te estás dejando el margen de beneficio en el camino. Consumir IA mediante APIs y pago por tokens es como alquilar un piso de por vida: cada mes, la hipoteca.
Si tu empresa procesa volumen, las APIs te van a desangrar.
- ¿Quieres que la IA analice las 4 horas de vídeo de las cámaras de tu fábrica para detectar cuellos de botella? La API te cobrará por cada frame procesado.
- ¿Quieres meter el audio de todas las llamadas de tu equipo comercial para extraer objeciones? La API te cobrará por cada minuto de transcripción y análisis.
- ¿Quieres que lea los 500 PDFs de tu base de conocimiento corporativa? La API te cobrará por cada token de entrada y salida.
El modelo de API está diseñado para que tú asumas el riesgo operativo (OPEX) y ellos se lleven la renta.
El cambio de chip: De PC Gamer a Nodo de IA de Borde
Los modelos Open Source como la familia Qwen 3.5 y 3.6 han roto el mercado. Son multimodales nativos (entienden texto, imagen, audio y vídeo) y corren en local.
¿Qué significa esto en cristiano?
- Coste marginal cero. Una vez que compras la GPU (sí, la misma que quiere tu hijo para el GTA VI), procesar 1 token o 10 millones de tokens te cuesta lo mismo: la electricidad.
- Cero fugas de datos. Tu información sensible no sale de tu oficina para ir a los servidores de California.
- Cero latencia. La IA responde en milisegundos porque está en tu red local, no dando saltos por internet.
La próxima vez que tu hijo te pida que le actualices el PC para estar «a la última», o tú mismo mires esa RTX 4090 de 24 GB con envidia, no mires solo los FPS.
Mira esos 24 GB de VRAM y dime si de verdad no tienes presupuesto para IA. Porque lo que tienes, lo que te falta, es visión de negocio para darte cuenta de que la mejor infraestructura de IA empresarial no está en la nube, está escondida en la torre de un PC gamer.
Mira, te voy a ser brutalmente sincero.
Si has llegado al final de este texto y sigues pensando que «no hay presupuesto» para la IA, el problema no es tu cuenta de resultados. El problema es que te están cobrando el peaje de la innovación por no saber dónde mirar.
Dejar de sangrar con las APIs y montar tu propia infraestructura de IA local no es magia negra, es ingeniería bien aplicada. Y para eso no necesitas contratar a un equipo de científicos de datos de Silicon Valley; necesitas a alguien que sepa qué botones tocar para que esos modelos open-source trabajen para tu negocio, en tu red y con tu hardware.
Si estás harto de tirar dinero en tokens cada vez que alguien hace una pregunta al chatbot de tu web, y quieres ver cómo tu empresa procesa datos, analiza vídeos y automatiza procesos sin que te llegue una factura de la nube a fin de mes…
Llámame.
No te voy a vender humo, ni te voy a pedir un presupuesto de seis cifras ni un proyecto de implementación de ocho meses. Vamos a mirar tu hardware, vamos a mirar tus cuellos de botella, y vamos a montar tu IA local. Rápido, sucio y rentable.
Tu competencia ya está dejando de alquilar su inteligencia. La única pregunta es si vas a ser tú quien implante la IA en su empresa, o el que se queje en la próxima convención del sector de que los márgenes cada vez son más estrechos.
¿Hablamos?
P.D.: Si tu hijo te pide la próxima generación de la tarjeta gráfica cuando salga, cómprasela. Pero esta vez, ponla en el balance de tu empresa como «Servidor local de inferencia de IA». Desgrávate y ponte a trabajar.